Calcolo. Ricerca. Futuro.
La scienza ha bisogno di potenza.
ReCaS-Bari è il più grande centro di calcolo scientifico della Puglia e uno dei maggiori a livello nazionale. Qui tecnologia, persone e idee lavorano insieme, ritagliandosi ruoli strategici in numerosi progetti scientifici internazionali.
ScopriConsulta il catalogo delle attività presentate al nostro stand
↗
PartecipaTi interessano opportunità di formazione, ricerca o collaborazione?
↗
ReCaS in numeri ↓
✦HIGH PERFORMANCE COMPUTING
✦CLOUD HOSTING
✦BIG DATA
✦OPEN SCIENCE
✦ARTIFICIAL INTELLIGENCE
✦DATA STORAGE
✦REMOTE COMPUTING
simulazioni e calcolo accelerato
alla rete GARR
Le attività
presentate.
In questa sezione raccontiamo nel dettaglio le esperienze ideate dallo staff del data center per la Notte dei Ricercatori 2026, insieme alle idee e alle scelte che hanno guidato la loro realizzazione.
Attività 01 · Intelligenza artificiale
Intelligenza Artificiale:
un modello che farnetica
in stile dantesco.
MACHINE
MEETS
POETRY
MEETS
POETRY
DAL CONCETTO AL CODICE
Una piccola guida
all’intelligenza artificiale.
01 Partiamo dalle aspettativeIntroduzione
Quando si parla di intelligenza artificiale si pensa subito a sistemi come ChatGPT o chatbot affini: sistemi capaci di sostenere conversazioni, scrivere codice e lavorare con grandi quantità di conoscenza.
È un riferimento comprensibile, ma rappresenta la fascia più complessa e costosa dell’AI. I sistemi di frontiera nascono all’interno di programmi industriali con investimenti nell’ordine dei miliardi. Una fase di addestramento può tenere occupate migliaia o decine di migliaia di GPU — le cosiddette “schede grafiche”, progettate per eseguire moltissimi calcoli in parallelo e, nei modelli più potenti, molto più costose dei comuni processori — per settimane o mesi: in totale, un ordine di grandezza di milioni di GPU-ore. A questo si aggiunge il lavoro umano necessario per preparare i dati, progettare l’infrastruttura, valutare le risposte e migliorare sicurezza e affidabilità. I dettagli esatti dei modelli usati da ChatGPT non sono pubblici, quindi questi numeri descrivono la scala dei sistemi di frontiera, non una specifica versione.
Ma l’AI non comincia da quella scala. Con un normale computer, un dataset circoscritto e poche righe di codice si può costruire in breve tempo un’applicazione molto più limitata, ma già capace di imparare uno schema. In questa sezione viene considerato un caso volutamente semplice, così da mettere a fuoco proprio questo principio fondamentale.
02 Numeri che imparano dai datiCosa significa addestrare una rete
La parola “intelligenza” può trarre in inganno: in una rete neurale non c’è una mente che pensa o comprende, ma matematica e statistica applicate ai dati.
Addestrare una rete significa farle maturare una sorta di “esperienza” numerica: osservando molti esempi, il sistema individua le regolarità che ricorrono più spesso e le usa per formulare una previsione.
Una rete neurale è, in sostanza, una grande funzione matematica composta da tanti parametri regolabili: i pesi. All’inizio sono soltanto numeri quasi casuali.
Durante l’addestramento vengono mostrati al modello molti esempi. Per ciascuno viene richiesta una previsione, si misura quanto differisce dalla risposta corretta attraverso una funzione di errore — la loss — e i pesi vengono modificati leggermente nella direzione che riduce quell’errore. Ripetendo il ciclo migliaia di volte, i numeri finiscono per codificare regolarità presenti nei dati.
01EsempioIl modello riceve un dato
→
02ErroreConfronta previsione e risposta
→
03CorrezioneAggiorna di poco i pesi
↻
Il risultato dell’addestramento non è un elenco di regole scritto da una persona: è un insieme di numeri che rende alcune risposte statisticamente più probabili di altre.
03 Dal testo alla previsione del carattere successivoUn piccolo modello per emulare Dante
Il testo della Divina Commedia viene trasformato in sequenze di caratteri e a una piccola rete di intelligenza artificiale viene posta sempre la stessa domanda: dato ciò che è stato appena letto, quale carattere viene dopo?
Il testo dell’opera viene suddiviso in finestre di 30 caratteri. Le finestre non sono separate: ciascuna inizia 3 caratteri dopo la precedente e ne condivide quindi 27 con essa. In questo modo i 558.240 caratteri della Divina Commedia diventano 186.070 esempi. Nel testo sono presenti 40 caratteri distinti, tra lettere, segni di punteggiatura, spazi e altri simboli.
Leggendo questi esempi, la rete prova a imparare quale carattere abbia statisticamente più probabilità di comparire dopo una determinata sequenza, sulla base delle regolarità incontrate durante l’addestramento.
Quando viene generato un nuovo testo, la composizione procede quindi lettera per lettera e si basa esclusivamente su questo processo statistico: viene aggiunto il carattere considerato più probabile, poi il procedimento ricomincia.
558kcaratteri totali
40simboli distinti
60iterazioni (dette epoche nel gergo)
OUTPUT · EPOCA 59GENERAZIONE GREEDY
«Tosto che l’anima mi venne a l’oscia
che sarà non si venne ancor sì spesso,
non so che non si tresto a la mente…»
Il risultato non ha un significato compiuto e inventa parole: il modello ha poco contesto, un dataset minuscolo rispetto a un chatbot moderno e nessuna vera conoscenza dell’italiano. Eppure apprende qualcosa di riconoscibile: apostrofi, interruzioni di verso, ritmo, costruzioni ricorrenti e frammenti che ricordano il volgare dantesco. Non ha imparato cosa Dante volesse dire; ha imparato alcuni pattern statistici di come quel testo appare.
È possibile scaricare il codice di training.
04 Metti alla prova il tuo orecchioIl verso è di Dante o dell’AI?
Alcuni versi sono autentici, altri provengono dal piccolo modello. Basta scegliere una risposta per scoprire quanto la forma possa ingannare l’orecchio umano.
«Chi poria mai pur con parole sciolte»
«Non possemo altri sempre sanza schiera»
«Suso in Italia bella giace un laco»
«La terra che là su si fece a la mente»
«Che l’anima mi fece al mondo son dispresso»
«Sovra candido vel cinta d’uliva»
05 Oltre le paroleL’intelligenza artificiale non è solo chiacchiere
L’AI non deve necessariamente imparare a parlare. Può cercare regolarità in quasi ogni dataset, purché i dati siano abbastanza puliti, comprensibili e rappresentativi del problema.
Lo stesso principio — trasformare esempi in numeri, misurare l’errore e correggere dei parametri — permette a modelli relativamente piccoli come quello che abbiamo appena trattato di affrontare compiti molto diversi.
DATI TABELLARI01
Chi è sopravvissuto al Titanic?
In questo esempio, 891 passeggeri diventano le righe di una tabella. Classe del biglietto, sesso, fascia d’età, tariffa, porto d’imbarco, titolo e presenza di familiari sono sufficienti perché un modello relativamente piccolo riesca a prevedere la sopravvivenza con un’accuratezza vicina al 90%.
Questo è possibile perché, sotto la superficie, quei dati contengono informazioni legate alle probabilità di sopravvivenza: l’età, per esempio, può riflettere indirettamente la prestanza fisica. Le persone possono intuire alcune di queste relazioni, ma difficilmente riescono a quantificare il peso di ogni fattore e delle loro combinazioni; il modello prova a farlo statisticamente.
ETÀCLASSETARIFFAFAMIGLIA
NEI DATI STORICI
342 su 891
passeggeri sopravvissuti
QUOTA DI SOPRAVVIVENZA
Donne74%
Uomini19%
1ª classe63%
2ª classe47%
3ª classe24%
IMMAGINI02
Che cifra è stata scritta?
Immaginiamo di voler leggere automaticamente le cifre compilate a mano su moduli, buste o documenti. La grafia cambia da persona a persona: i numeri possono essere storti, schiacciati, incompleti o scritti con tratti molto diversi.
Per insegnare questo compito al modello si raccolgono migliaia di esempi, ognuno ridotto a una piccola immagine in scala di grigi da 28 × 28 pixel. La rete non vede una “cifra” come la vede una persona: riceve 784 valori numerici e impara quali configurazioni di pixel ricorrono più spesso per ciascun numero.
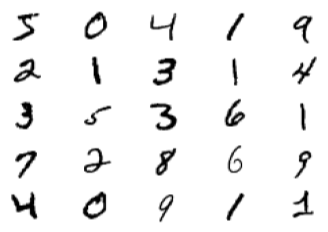
Anche un modello piccolo, addestrato in pochi minuti con una GPU noleggiata gratuitamente online, può affrontare un compito del genere. Il valore pratico è enorme: lo stesso principio può riconoscere non soltanto cifre, ma anche lettere, parole, codici e altri segni, aiutando ad automatizzare e industrializzare processi ripetitivi di lettura e classificazione.
La capacità di riconoscere schemi nelle immagini viene applicata sempre più anche in medicina. Su alcuni compiti diagnostici ben definiti, per esempio l’analisi di determinate radiografie, sistemi di AI hanno raggiunto o superato le prestazioni di radiologi esperti.
Il confronto riguarda compiti e dataset specifici: le prestazioni devono sempre essere validate nel contesto clinico. Approfondisci lo studio ↗06 Un cambio di scala · Verso la prossima attivitàDai piccoli esperimenti a un modello ospitato a ReCaS
Fin qui sono stati introdotti i concetti teorici alla base dell’intelligenza artificiale e alcuni esperimenti in piccola scala: modelli costruiti “in casa”, in poco tempo e con risorse molto limitate. Sono esempi utili per osservare il meccanismo dell’apprendimento, ma lontani dalla potenza dei sistemi utilizzati ogni giorno da milioni di persone.
I modelli impiegati da servizi come ChatGPT o Claude Code operano su una scala completamente diversa. Dietro le loro prestazioni ci sono investimenti enormi, grandi quantità di dati, infrastrutture specializzate e un lungo lavoro umano di progettazione, valutazione e perfezionamento. Sono prodotti commerciali: non vengono eseguiti sul computer dell’utente, ma nei data center del fornitore.
Quando si invia una richiesta, il testo raggiunge attraverso Internet quelle macchine, viene elaborato e la risposta torna al dispositivo dell’utente. È un meccanismo molto comodo, ma introduce costi, dipendenza dal servizio e questioni importanti sulla privacy e sulla gestione dei dati trasmessi.
Modelli avanzati, eseguiti localmente
Esistono però anche modelli molto prestanti, spesso vicini a quelli commerciali in numerosi compiti, i cui pesi vengono distribuiti pubblicamente. Come si è già visto, i pesi sono i parametri numerici prodotti durante l’addestramento: rendendoli scaricabili, il modello può essere riprodotto ed eseguito su una macchina propria, senza dover affidare ogni richiesta a un servizio esterno.
Il loro addestramento resta costoso e complesso ed è svolto da grandi gruppi di esperti; ciò che viene condiviso è il risultato di quel lavoro. Per la prossima esperienza è stato scaricato uno di questi modelli, chiamato Qwen2.5-32B-Instruct-AWQ, e installato su una macchina di ReCaS. Possiede circa 32 miliardi di parametri, cioè i valori numerici appresi durante l’addestramento che fin qui sono stati chiamati pesi. La macchina dispone di una GPU NVIDIA H100 con 80 GB di memoria: un componente progettato per accelerare i calcoli di intelligenza artificiale nei data center, dal valore indicativo nell’ordine dei 30.000 euro per singola unità. Questa infrastruttura può eseguire localmente un chatbot capace di interpretare una richiesta e generare una risposta articolata, offrendo un’esperienza simile, nel funzionamento, a quella di servizi come ChatGPT, seppur meno prestante.
Il passaggio successivo: il cloud hosting
Nella prossima attività si parlerà di cloud hosting: il principio che permette di rendere disponibili su Internet siti e applicazioni eseguendoli su server sempre connessi, spesso ospitati e gestiti proprio all’interno di data center.
Questo concetto verrà messo in pratica attraverso una pagina web dedicata, sulla quale i visitatori dello stand potranno lasciare un messaggio rivolto a chi desiderano. La pagina generata sarà raggiungibile da qualunque luogo tramite Internet attraverso un indirizzo unico.
Per riunire quanto visto finora, ogni messaggio verrà rielaborato dal modello Qwen2.5 installato localmente a ReCaS e trasformato nel suo “corrispettivo dantesco”, conservandone il significato. Qwen2.5 è decisamente più prestante del piccolo modello presentato all’inizio della pagina: può tenere conto del contesto, della struttura del linguaggio e del significato complessivo del testo, risultando quindi pienamente adeguato a questo compito.
DAL SERVER AL MONDO
Una piccola guida
al cloud hosting.
01 Dietro ciò che appare sullo schermoCome funziona davvero Internet?
La nostra quotidianità passa continuamente dalla rete: apriamo siti, leggiamo notizie e usiamo applicazioni che recuperano contenuti online senza mostrarci ciò che accade dietro l’interfaccia. È quindi naturale chiedersi: da dove arrivano davvero tutte queste informazioni?
Il modello più comune è chiamato architettura client–server. Il client è il programma con cui chiediamo qualcosa — per esempio il browser o un’app sul telefono. Il server riceve la richiesta, cerca i file o i dati necessari e invia una risposta. Il browser — il software o l’applicazione con cui navighiamo in Internet, come Google Chrome, Safari o Firefox — usa poi quella risposta per costruire ciò che vediamo sullo schermo.
Non bisogna pensare ai server come a computer necessariamente speciali: il termine fa riferimento soprattutto al ruolo svolto dalla macchina. Anche un normale PC domestico può diventare un server: se configurato correttamente e reso raggiungibile dalla rete, può pubblicare un sito accessibile dall’esterno.
Il viaggio della richiesta dal client al server avviene secondo regole condivise, chiamate protocolli. Nel Web si usa soprattutto HTTP e la sua controparte cifrata e sicura, HTTPS: questo protocollo stabilisce come formulare una richiesta e come restituire una risposta.
Questo spiega perché molti indirizzi condivisi iniziano con https://: quella parte indica semplicemente il protocollo da usare. Nei browser moderni può quasi sempre essere omessa, perché il programma prova automaticamente ad aprire il sito tramite HTTPS. Per esempio, scrivere google.com nella barra degli indirizzi conduce normalmente allo stesso sito indicato dall’indirizzo completo https://google.com.
RICHIESTA HTTPS
→
Fin qui il meccanismo sembra lineare: un client domanda, il server risponde. Bisogna però tenere conto dei problemi che possono emergere quando questo modello viene applicato su larga scala. Immaginiamo, per esempio, un social network o un altro servizio usato da milioni di persone: un solo computer non può gestire in autonomia milioni di richieste al secondo. Inoltre rappresenterebbe un singolo punto di guasto: un problema a quella macchina o all’infrastruttura a cui è collegata potrebbe rendere irraggiungibile l’intero servizio.
Carico
Molti visitatori possono chiedere contenuti nello stesso istante. Il lavoro deve essere distribuito tra più macchine: se una singola macchina si sovraccarica, smette di funzionare correttamente.
Guasti
Dischi, reti e computer possono smettere di funzionare. Avere copie e percorsi alternativi evita che un singolo problema fermi tutto.
Distanza
Più il server è lontano, più tempo impiegano richiesta e risposta. Distribuire i servizi riduce l’attesa percepita.
Concentriamoci sul terzo punto: la distanza. In genere, il ritardo tra la richiesta del client e la risposta del server prende il nome di latenza. Una parte della latenza dipende proprio dalla distanza tra i due punti: in una fibra ottica il segnale viaggia a circa 200.000 chilometri al secondo, quindi il trasferimento non è immediato.
La latenza, però, non dipende soltanto dalla lunghezza della linea che unisce client e server. Il percorso reale non è quasi mai diretto: i dati attraversano cavi, apparati di rete e diversi nodi intermedi — i router. Ciascun passaggio richiede un piccolo tempo di elaborazione, che si somma al tempo impiegato dall’informazione per percorrere fisicamente la rete.
Per questo motivo — e per affrontare anche i problemi di carico e affidabilità — i grandi servizi vengono eseguiti contemporaneamente su molti server, spesso distribuiti in aree geografiche differenti.
Distribuire un servizio risolve alcuni problemi, ma ne introduce altri. Nasce infatti una nuova domanda: come mantenere coerenti le informazioni tra tutte queste copie? I dati devono essere replicati e sincronizzati; le richieste devono essere indirizzate verso macchine disponibili; i guasti devono essere rilevati e gestiti.
Insomma, più ci si riflette e più si arriva a una conclusione importante:
Più osserviamo da vicino il funzionamento di Internet — una risorsa tanto presente e affidabile da sembrarci quasi “naturale” — più scopriamo una rete di problemi e scelte invisibili. Ciò che utilizziamo con tanta facilità è invece il risultato artificiale del lavoro continuo di milioni di persone, che progettano, costruiscono e mantengono sistemi complessi in ogni parte del mondo.
Torniamo ora al nostro argomento principale. Anche un sito molto più piccolo di un social network deve rispondere a una domanda concreta: dove può funzionare il server affinché la pagina rimanga raggiungibile?
È nella risposta a questa domanda che entrano in gioco i concetti di hosting, data center e cloud computing.
02 Dalle macchine reali alla nuvolaHosting, data center e “il mondo Cloud”
Dare a un sito una “casa” su una macchina connessa alla rete, affinché possa rispondere alle richieste dei visitatori, è ciò che chiamiamo hosting.
In termini più precisi, significa eseguire un sito o un’applicazione su un server raggiungibile attraverso Internet e predisporre tutto ciò che serve perché continui a funzionare. È facile ottenere una pagina visibile per qualche minuto; è molto più difficile renderla disponibile con continuità, in sicurezza e anche quando qualcosa va storto.
In teoria, anche un comune computer di uso casalingo potrebbe svolgere questo compito. Dovrebbe però rimanere sempre acceso, dipenderebbe dalla connessione domestica e richiederebbe a chi lo gestisce di occuparsi di aggiornamenti, sicurezza, copie dei dati e possibili guasti. Persino per un piccolo progetto, sono responsabilità poco pratiche da sostenere giorno e notte.
Per questi motivi, i server vengono spesso predisposti all’interno di un data center: una struttura costruita appositamente per ospitare e mantenere operative macchine e servizi informatici. Qui troviamo connessioni veloci, alimentazione e raffreddamento controllati, monitoraggio, protezioni fisiche e sistemi di riserva. Nessun servizio è magicamente infallibile, ma l’infrastruttura è progettata per ridurre le interruzioni e mantenere le macchine raggiungibili con elevata continuità.
24/7l’obiettivo è essere raggiungibili giorno e notte
RETEconnessioni ad alta capacità e percorsi ridondanti
RISERVAenergia, copie e sistemi pronti in caso di guasto
CONTROLLOmonitoraggio continuo di macchine e servizi
Una macchina collocata in un data center non deve essere utilizzata davanti a uno schermo e a una tastiera fisicamente collegati. Attraverso Internet e protocolli appositi può essere raggiunta e amministrata a distanza: lo sviluppatore può impartire comandi, installare programmi, trasferire il codice della propria applicazione, avviarla e aggiornarla. In pratica, può controllare da remoto un computer che si trova altrove e usarlo per rendere disponibile il proprio servizio su Internet.
Quando capacità di calcolo, memoria, archiviazione e rete vengono offerte da remoto e possono essere attivate o adattate secondo le necessità, parliamo di cloud computing. Quando queste risorse vengono usate per pubblicare un sito o un’applicazione, parliamo più precisamente di cloud hosting. La parola inglese cloud significa letteralmente nuvola.
Il nome può ingannare: non c’è nulla di immateriale, nessuna “nuvola” lontana. Nei diagrammi tecnici Internet e le reti esterne venivano spesso rappresentate con una nuvola, perché mostrarne tutti i collegamenti avrebbe reso il disegno illeggibile. Quel simbolo è diventato il nome di un modello di servizio, ma dietro la “nuvola” continuano a esserci edifici, server, dischi, cavi, energia e persone che amministrano l’infrastruttura.
Il vantaggio per chi sviluppa un’applicazione è dunque tangibile: può concentrarsi sul servizio da realizzare senza dover acquistare, installare e sorvegliare personalmente ogni componente fisico. Il server rimane reale, una macchina fisica; è la sua gestione a diventare più distante e, per chi lo utilizza, più semplice.
03 La stessa risposta o una pagina su misuraPagine statiche e pagine dinamiche
Non tutte le pagine che richiediamo a un server esistono già, complete in ogni loro parte. Molte vengono costruite nel momento stesso in cui sono richieste, in base all’utente che effettua la richiesta, ai dati disponibili o ad altri fattori.
Un esempio è la pagina di benvenuto di un servizio bancario: dopo l’accesso, il server riconosce l’utente e prepara una risposta personale, mostrando informazioni come il suo nome, il saldo e i movimenti del conto. La struttura della pagina rimane simile per tutti, ma i dati visualizzati cambiano da persona a persona.
Già pronta
Il server invia gli stessi contenuti a ogni visitatore: è il caso ideale per pagine informative che cambiano raramente.
/chi-siamo.html
Creata dai dati
Il server recupera i dati associati all’utente e costruisce la pagina al momento: lo stesso indirizzo può quindi mostrare informazioni differenti a persone diverse.
/m/ciao-nadira
Le pagine dei messaggi di questa esperienza sono dinamiche: condividono la stessa veste grafica, ma testi, firma e QR code cambiano in base all’indirizzo visitato.
04 Cloud hosting, ma in miniaturaUna pagina per ogni messaggio
In questa attività ogni visitatore pubblicherà una piccola pagina web raggiungibile tramite Internet, scegliendone personalmente il contenuto e l’indirizzo.
Si raccolgono un messaggio, una firma e un nome per la pagina tramite un modulo di sottomissione. Il server controlla che quell’indirizzo non sia già stato usato e conserva i dati; da quel momento, chi visita il link riceve la pagina associata a quel messaggio.
Non viene quindi creato a mano un nuovo sito ogni volta, ma una nuova pagina all’interno di questo stesso sito. È una versione in miniatura dello stesso principio illustrato fin qui e usato da social network, negozi online e moltissimi servizi sul Web.
Compilamessaggio, firma e URL
→
Salvail server conserva i dati
→
Pubblicala pagina diventa raggiungibile
→
Condividitramite link o QR code
05 Il collegamento con l’attività precedenteDove entra in gioco l’intelligenza artificiale?
Prima della pubblicazione, il messaggio compie una deviazione: viene affidato a un modello di intelligenza artificiale ospitato localmente su una macchina di ReCaS.
Il sito contatta il modello tramite Internet; il modello interpreta il testo inserito e lo riscrive in non meno di due versi, richiamando lo stile di Dante senza cambiarne il significato.
Il risultato torna al server su cui è stato hostato questo sito web e viene salvato insieme al messaggio originale. La pagina finale può così mostrare entrambi, mentre un QR code codifica il suo indirizzo e permette di aprirla rapidamente da un altro dispositivo.
IN PARTENZA«Ci vediamo domani davanti al mare»
HTTPS →
RECAS · GPU H100Modello I.A.comprende · trasforma · risponde
→ WEB
ALL’ARRIVODimani, presso l’onde marine,
ci troverem l’un lato dell’altre.
ci troverem l’un lato dell’altre.
06 Dalla spiegazione all’esperienzaÈ il momento di lasciare il tuo messaggio
Ora tocca a te: scegli cosa affidare al mondo, lascia che il modello di intelligenza artificiale lo trasformi e pubblica la tua piccola pagina sul Web.
Al termine potrai aprire immediatamente il risultato, copiarne il collegamento oppure usare il QR code per condividerlo. Ricorda che messaggio e firma saranno visibili a chiunque possieda l’indirizzo: evita dati personali o informazioni riservate.
INIZIA L’ESPERIENZA
Crea il tuo
Crea il tuo
messaggio dantesco
Scrivi · trasforma · pubblica
→Il prossimo passo può partire da qui
Opportunità
per crescere.
ReCaS-Bari è un luogo in cui ricerca, formazione e innovazione si incontrano. Tieni d’occhio i canali ufficiali per scoprire bandi, percorsi formativi, eventi e possibilità di collaborazione.
Impara
Formazione
Scuole, corsi e occasioni per avvicinarsi al calcolo scientifico, al cloud e ai dati.
Partecipa
Ricerca
Progetti nazionali ed europei al confine tra infrastrutture digitali e scienza.
Connettiti
Collaborazioni
Competenze e risorse condivise con università, enti pubblici e comunità scientifiche.